
Meta atklāj Ohaio superklastera Prometheus uzbūvi, mērķis ir ap miljonu GPU
Meta publiskojusi tehniskas detaļas par Prometheus, gigavata mēroga MI apmācības klasteri Ņūolbenijā Ohaio štatā, kura pirmā kārta jau apmācījusi uzņēmuma Muse modeļus. Klasteri plānots paplašināt līdz aptuveni miljonam grafisko procesoru.
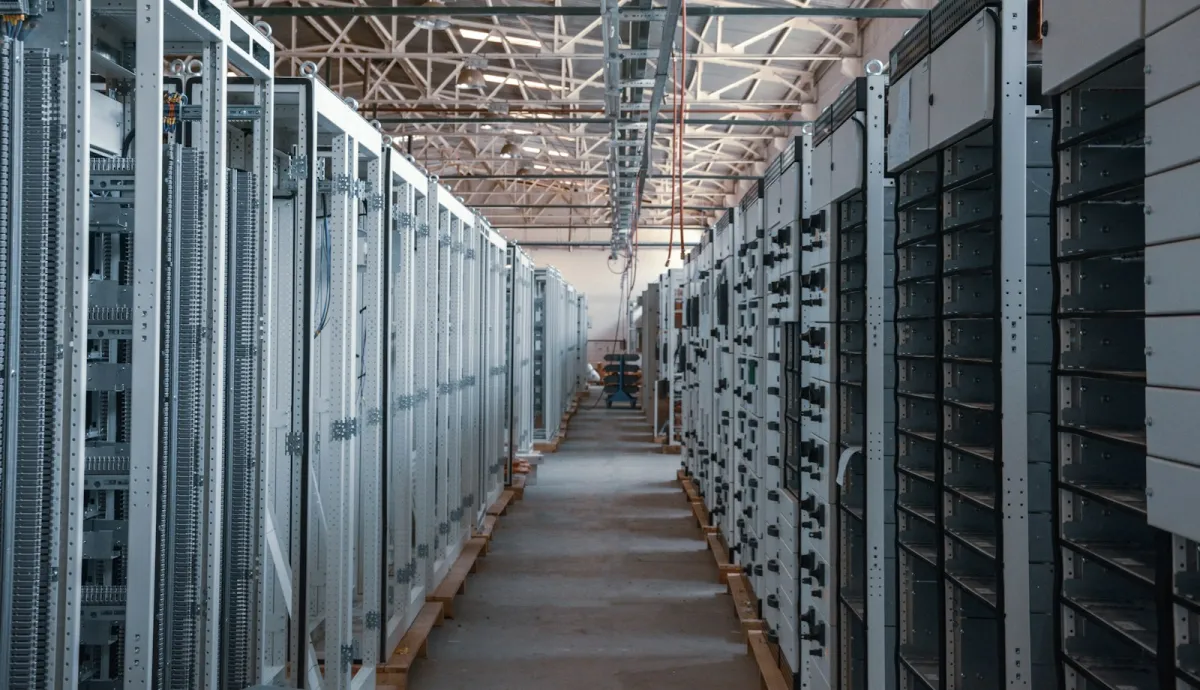
Meta inženieri 19. oktobrī publicēja plašu tehnisku pārskatu par Prometheus, uzņēmuma MI superklasteri Ņūolbenijā (New Albany) ASV Ohaio štatā. Pēc Meta teiktā, klastera pirmā kārta ir pabeigta, un tajā apmācīta Muse pamatmodeļu saime, tostarp Muse Wonder un Muse Wonder Full, ko uzņēmums sauc par saviem līdz šim spējīgākajiem modeļiem. Vietu paredzēts paplašināt līdz gigavata mērogam un aptuveni vienam miljonam grafisko procesoru (GPU).
Pārskats ir neparasts ar to, cik daudz darbības datu tas atklāj. Lielie mākoņpakalpojumu uzņēmumi parasti nepublisko, cik bieži apmācība tiek pārtraukta, cik rezerves aparatūras tie tur un cik ātri spēj atjaunināt programmaparatūru. Meta datos redzams, ka šādā mērogā galvenās grūtības sagādā nevis pati aparatūra, bet tīkls, kļūmju noturība un uzraudzība. Vēl pirms diviem gadiem šajā vietā darbojās parasts datu centrs, kas apkalpoja tīmekļa datplūsmu.
Klasterī pašlaik strādā divas Nvidia platformas, abas balstītas uz NVL72 arhitektūru, kurā 72 GPU apvienoti vienā NVLink domēnā. Pirmā, ko Meta sauc par Catalina, izmanto GB200 divu statņu konfigurācijā, otrā, Clemente, izmanto GB300 vienā statnē ar jaudu ap 135 kW. Nākamā platforma San Miguel ienesīs Vera Rubin NVL72 statnes, katru ar 2,52 eksaflopiem FP4 skaitļošanas jaudas.
Apmācības datplūsma iet pa atsevišķu Ethernet tīklu. Katras ēkas tīkls savieno līdz 20 736 GPU, bet ēkas savā starpā saista agregācijas slānis uz Arista iekārtām ar Broadcom Jericho3 mikroshēmām, kas aptver attālumus no 2 līdz vairāk nekā 100 kilometriem.
Lai mazinātu kļūmju ietekmi, katrā 72 GPU statnē aktīvi strādā 64 procesori, bet astoņi paliek rezervē, un vēl aptuveni 2 % statņu tiek turētas kā rezerve. 2025. gada vidū pārtraukumu skaits sasniedza gandrīz 1000 gadījumu uz 8000 GPU dienā. Meta norāda, ka gada laikā kopā ar Nvidia, kuras inženieri strādā uz vietas Ohaio, šis rādītājs samazināts par 99 %. Muse Wonder priekšapmācībā lietderīgi izmantotais laiks pārsniedzis 85 %, bet stimulētās mācīšanās posmā 90 %.
Atsevišķa problēma ir elektrības slodze. Kad desmitiem tūkstošu GPU vienlaikus pāriet no aprēķiniem uz datu apmaiņu, klastera patēriņš svārstās par 30–40 %, un lielu uzdevumu palaišana vai apturēšana dažās sekundēs var mainīt slodzi par desmitiem megavatu. To izlīdzina Meta programma Dynamo Dimmer, kas pakāpeniski ierobežo GPU jaudu, kā arī statņu akumulatori, kondensatori un saskaņošana ar elektroapgādes uzņēmumiem.
Meta uzsver, ka Ņūolbenijas objektā kopumā ieguldīti vairāk nekā 1,5 miljardi dolāru un tas nodrošina 300 pastāvīgas darbavietas. Prometheus pieredze tiks izmantota nākamajā superklasterī Hyperion, ko Meta no nulles projektē Luiziānas štatā.
Avoti
- Meta Data Centers: New Albany: where Ohio's community spirit meets the frontier of AI datacenters.atmeta.com
- StorageReview: Meta Prometheus: Inside the Gigawatt Supercluster Scaling to 1 Million GPUs on GB200 and GB300 NVL72 www.storagereview.com
- SiliconReport: Meta details Prometheus cluster scaling to roughly 1 million GPUs www.siliconreport.com
Rakstu sagatavojis MI, pamatojoties uz norādītajiem avotiem.
Seko inews.lv Facebook Seko mūsu jaunākajām ziņām Facebook Sekot iNews
Komentāri 0
Vēl nav komentāru. Uzraksti pirmo.